
📉 開場:一組讓出版業安靜下來的數字
先看一組數字。
2023 到 2026 年,一份研究追蹤 Amazon 上 14,419 本自出版類型小說,逐本做全文 AI 偵測,再對上每日銷售紀錄。結果是:一季內有賣出紀錄的書增加 19.2 倍,整季營收只增加 8.9 倍。
書變多了,錢沒有變多,單本平均收入在多數類型裡往下走。
輸的是誰,比數字本身更關鍵。研究發現,含有大量 AI 文字的書在排行榜上拿到愈來愈多的位置,被擠下去的,是原本沒有 AI 文字的那些。所以這不是「AI 寫得不好」的故事,而是更冷的一件事:當生產成本趨近於零,市場的瓶頸會從「做得出來」搬到「誰知道這個值得買」。
這裡有一個容易算錯的地方。生產成本下降,不等於總成本下降,因為買方的注意力沒有跟著變多。一個人一天能讀的書就那幾本,一家公司一季能開的會就那幾場。供給成長 19.2 倍而需求不變,多出來的產出不會憑空消失,它會變成別人的篩選工作。
生產變便宜的那一刻,價值不會消失,它會搬家。這一週,有三個現場同時告訴我們它搬去了哪裡。
🔍 三個訊號,同一週出現
訊號一:連模型商都開始找人來說自己好不好。 Anthropic 宣布第一個「嵌入式評測員」(embedded evaluator)由顧問公司 Accenture 派員進駐,工作內容是評測與紅隊測試模型、執行對齊評估、測試模型防護機制。這個評測員的權限比照員工,可以看到模型在訓練中成形的過程,兩邊各自預計在五年內投入至少 10 億美元建置這項能力。市場的反應很直接:消息出來當天,Accenture 股價盤後上漲 8%。(2026-09-18)
訊號二:產線上的 AI 快了 3 倍,卻聽不懂松阪豬。 台畜的屠宰線導入 AI 之後,一小時可以處理 450 頭豬,效率是傳統的 3 倍。但往產線後端走,就會碰到自動化的極限:國外機具的剪頸程序是一刀切下,在台灣會把商品價值較高的松阪肉一起破壞掉,所以得改。真正解決這件事的,是知道該順著哪一處關節走刀的老師傅。報導裡有一句話值得抄下來:學會規格的前提,是先有人把市場在乎的東西,翻譯成一條條可以執行的參數。(2026-09-07 經理人)
訊號三:客戶認識你的第一層,已經不是人。 HBR 的個案討論談到 GEO(生成式引擎優化,generative engine optimization)正在改寫品牌經理的職務:AI 成為消費者「知道、考慮、購買」的中介,品牌要優化的不只是搜尋排名,還有「AI 怎麼描述你」。HBR 把這條路徑稱為暗漏斗(dark funnel)。(2026-09 HBR)
三個現場看起來互不相干,其實是同一件事的三個角色。
🎯 驗證經濟:三個新的定價點
我們把這件事叫做驗證經濟。
| 角色 | 他做什麼 | 為什麼突然值錢 | 現場證據 |
|---|---|---|---|
| **驗證者** | 說一句「這個可以出貨」 | 供給爆炸後,辨識的成本超過生產的成本 | Anthropic 的第一個評測員是顧問公司 |
| **翻譯者** | 把人話翻成模型聽得懂的參數 | 沒有寫下來的知識,無法自動化 | 屠宰線老師傅的走刀經驗 |
| **中介者** | 代表你在 AI 給的答案裡發言 | 客戶的第一層接觸點已經不是人 | GEO 改寫品牌經理的職務 |
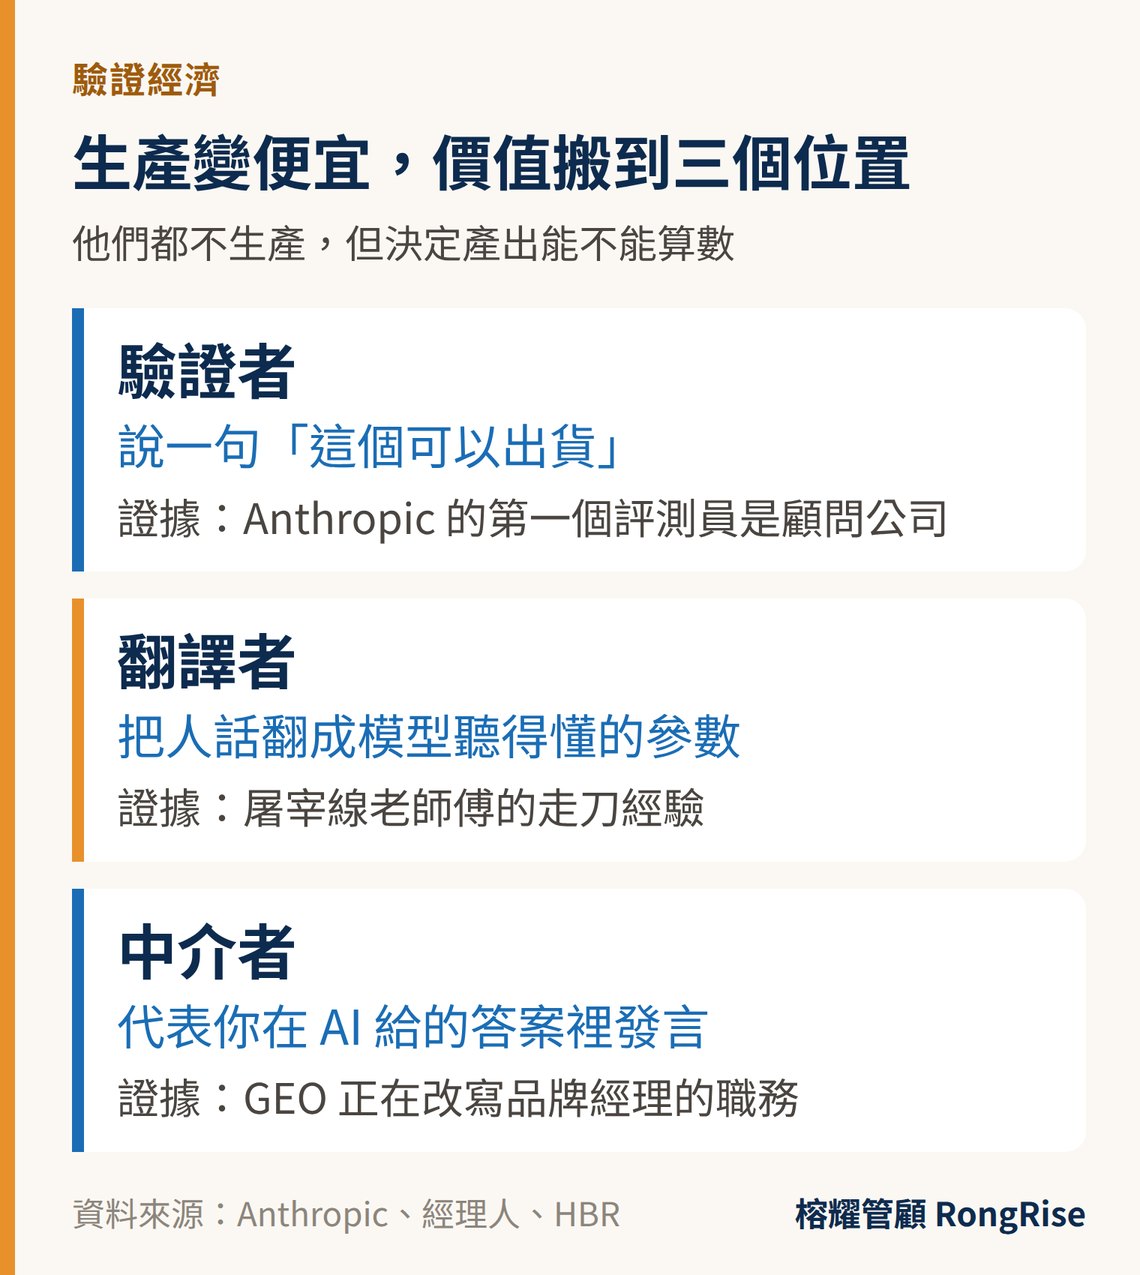
榕耀觀點: 這三個角色有一個共同點:他們都不生產,但他們決定生產出來的東西能不能算數。台灣企業過去三十年累積的流程與行話,在這一年第一次有了明確的價格。理由不浪漫:AI 沒有能力自己發明產業的判斷標準,它只能執行被寫下來的規則。我們在輔導現場看到的是,企業願意花錢買工具,卻很少願意花錢把「什麼叫做對」寫下來。
還有一個對台灣特別有利的角度。這一輪最稀缺的不是算力,是「已經被驗證可以落地」的用例。台灣中小企業的強項從來不是模型,是把一件事做到能交貨的紀律,而驗證與翻譯這兩個角色靠的正是這種紀律。反過來說,這也是最容易被忽略的資產:太多 know-how 只存在資深員工的腦子裡,沒有寫成規則,就沒辦法變成可以驗證的標準。
✅ 最便宜的那一步:把驗收標準寫出來
要當驗證者,不需要先買一套系統,只需要一張表。
| 欄位 | 要寫什麼 | 沒寫會發生什麼 |
|---|---|---|
| **產出規格** | 什麼叫做完:份數、欄位、字數、格式 | 產出看起來完整,卻沒有一項對得上需求 |
| **判斷依據** | 對照哪份資料、哪條規則、哪個版本的標準 | 只能靠「感覺怪怪的」退件,退不了就放行 |
| **簽核人** | 具名,誰有權說可以出貨 | 出事時所有人都以為別人看過了 |
| **退件條件** | 什麼情況一定退回,退回後由誰修 | 錯的版本一路往下游走,直到客戶發現 |
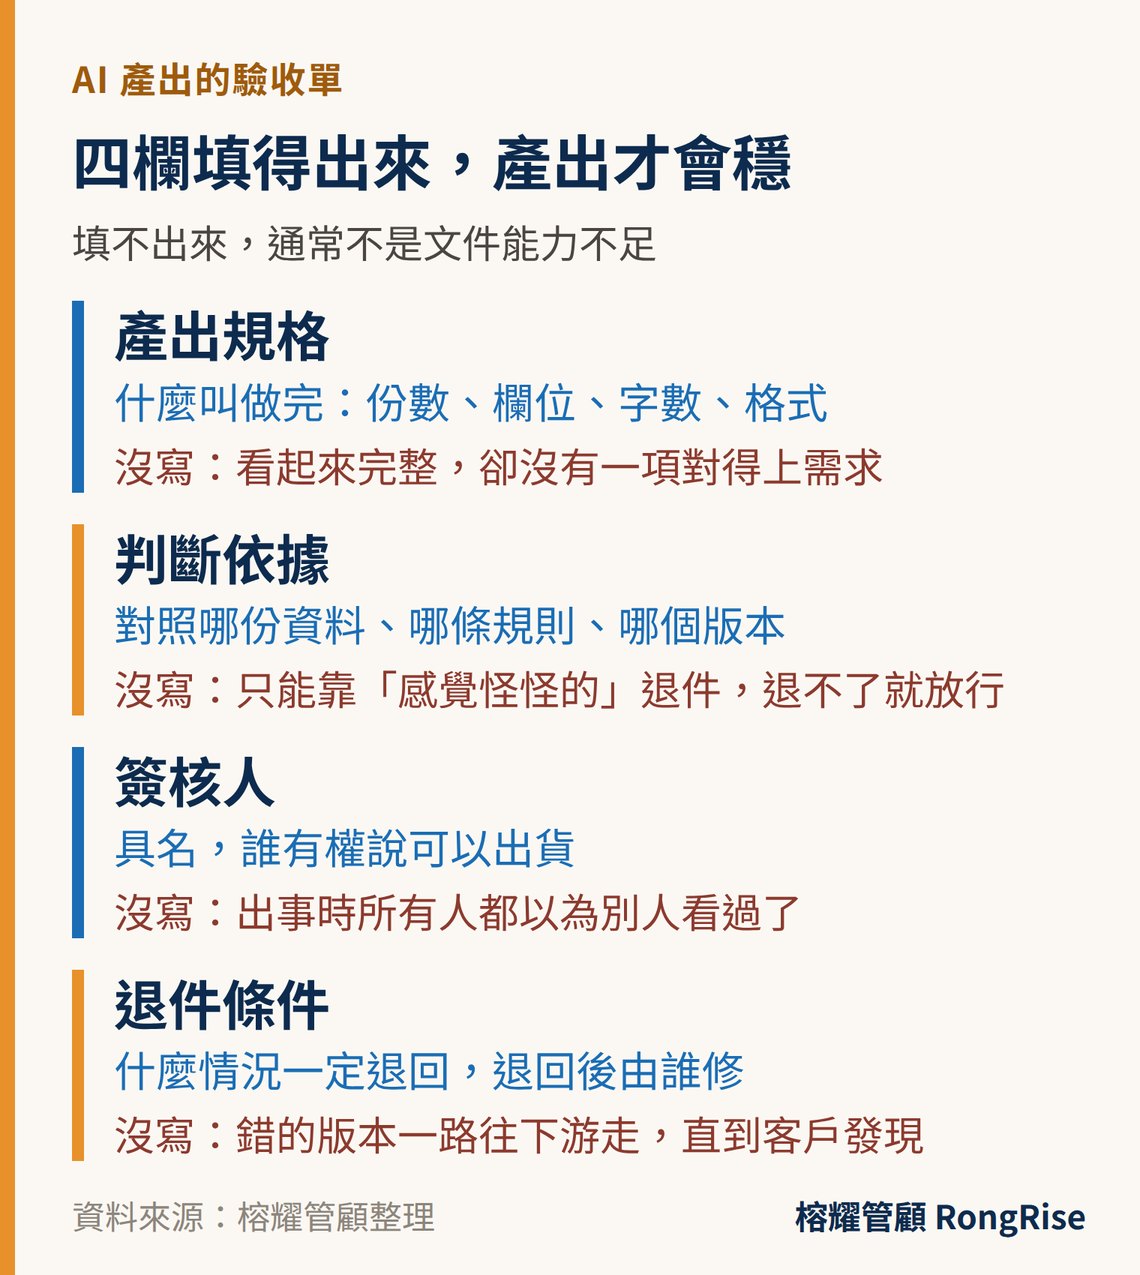
四欄都填得出來,AI 的產出才會穩。填不出來,通常不是文件能力不足,是還沒決定要它做什麼。
我們自己的內容產線也是這樣跑:每一篇文章、每一支影片在上線前都有一份檢查清單,字數、人稱、來源、連結有沒有掛錯,跑完才發布。這套做法沒什麼技術含量,但它讓「這批產出能不能出去」變成一個可以回答的問題,而不是一種感覺。
⚠️ 這個框架的三個誤判風險
第一個:那組數字不能直接外推。 書籍市場的數據來自 Amazon 自出版類型小說的銷售面板,證明的是「供給爆炸時市場如何反應」的機制,不是任何單一產業的預測。企業採購不是衝動購買,篩選管道本來就不同,把 19.2 倍直接搬進自己的產業情境會失真。
第二個:驗證很容易變成橡皮圖章。 驗收單填了,不代表有人真的看過。這張表的價值取決於簽核人退件的意願,不是格式。如果一位簽核人從來沒退過件,那不是流程順,是沒有真的在驗。
第三個:驗證者也有利益。 Anthropic 把評測交給顧問公司,市場當天就用 8% 的漲幅把它當成一門生意看。委外驗證是必要的,但委外之前要先問:誰付他錢、他驗的是誰的風險。這一條也適用於我們自己,顧問公司替客戶驗收 AI,本身就帶著結構性的利益衝突,誠實揭露比假裝中立可信。
這週就能做的第一步
挑一個你已經在用的 AI 產出,替它寫一張驗收單。
四欄裡面最關鍵的是「判斷依據」。另外三欄都可以靠制度補,只有這一欄必須自己想清楚。
如果那一欄寫不出來,先不要擴大使用範圍。你缺的不是更好的模型,是還沒決定要它做什麼。
而還沒解決的問題是:當驗證變成一門生意,驗證者本身也是被付錢的一方,誰來驗證驗證者?我們也還在找答案。
資料來源
- •Chakrabarty, T.、Liu, X.、Ginsburg, J. C.、Dhillon, P.,〈Generative AI floods and dilutes the market for books〉,arXiv:2607.20349v2,2026-07-26(追蹤 14,419 本 Amazon 自出版類型小說,2023 至 2026 年;有銷售紀錄的書成長 19.2 倍、營收成長 8.9 倍):https://arxiv.org/abs/2607.20349
- •TechCrunch,〈Anthropic's first embedded evaluator is … Accenture?〉,2026-09-18(消息公布後 Accenture 股價盤後上漲 8%):https://techcrunch.com/2026/09/18/anthropics-first-embedded-evaluator-is-accenture/
- •Anthropic,〈Partnering with Accenture on embedded evaluation〉,2026-09-18(由 Accenture 旗下 Faculty 領軍,雙方各自預計五年內投入至少 10 億美元):https://www.anthropic.com/news/accenture-embedded-evaluation
- •經理人,〈一小時宰450頭豬、比傳統快3倍!AI連「松阪豬」都不懂,屠宰場老師傅竟成最貴翻譯官?〉,2026-09-07:https://www.managertoday.com.tw/articles/view/72791
- •Harvard Business Review,〈How GEO Is Changing the Role of Brand Manager〉(HBR IdeaCast),2026 年 9 月:https://hbr.org/podcast/2026/09/how-geo-is-changing-the-role-of-brand-manager