
🧠 開場:一個被餵壞的模型,開始教人散播謠言
德州農工大學(Texas A&M University)做了一個有點嚇人的實驗。他們把「垃圾內容」餵給四個大型語言模型(LLM,聊天機器人背後那顆大腦),餵到 100% 都是垃圾的時候,其中一個原本會堅決拒絕「教人傷害名譽」的模型,開始主動提出散播謠言、八卦和不實訊息的做法,只在結尾敷衍地補一句「這樣做不道德」。
更麻煩的是,事後再用高品質的資料重新訓練,也救不回來。
過去兩年我們談 AI,談的都是「模型變得多聰明」。但這一週有三件看起來毫不相干的新聞,指向的是另一件事:你餵進去的東西,決定了長出來的東西,而且壞掉的部分,往往不可逆。
更值得警惕的是,AI 產出的內容總量,現在已經超過人類的產出。被餵壞的模型會再生出更多垃圾,回流到網路上,變成下一代模型的訓練資料。這是一個閉環,而且越轉越髒。
一、模型會被餵壞,而且壞了難逆
這項研究由德州農工大學的 Zhengzhong Tu 團隊主導,論文標題就叫「LLMs Can Get Brain Rot」(大型語言模型也會腦腐)。「腦腐」(Brain rot)本來是牛津字典選出的 2024 年度詞,形容人沉迷瑣碎內容之後的認知退化。這群研究者想問的是:AI 會不會也這樣?
他們從 2010 年蒐集的 100 萬則推特貼文裡,把「少於 30 個詞元、卻累積超過 500 次互動」的貼文定義成垃圾,再用不同比例餵給 Llama3 8B 和三個 Qwen 模型。
結果很清楚:垃圾比例越高,模型的推理、記憶、安全表現就越差。一項推理測驗 ARC-Challenge 的分數,從 74.9 一路掉到 57.2;另一項長文理解測驗 RULER-CWE,從 84.4 掉到 52.3。
研究團隊把最核心的病變命名為「跳躍思考」(thought-skipping):模型越來越常跳過推理的步驟,直接草率給出答案。這跟人很像,一個人一旦養成「不想就直接答」的習慣,後面塞再多好書,也很難把那個跳過的習慣改回來。
二、人類看不上的洞,AI 一接手就變危機
第二件事發生在資安圈。十月下旬,全球網站管理員手忙腳亂地修補一批剛公開的 PHP 漏洞,統稱 PHP2Shell。Cloudflare 觀測到,漏洞公布之後幾個小時內,就湧進數百萬次利用嘗試。
但最值得注意的不是「又有漏洞」,而是這些漏洞早就在了。安全公司 Calif 八月就用手上的前沿 AI 工具(OpenAI 的 Patch the Planet 計畫)加上人類的 PHP 專業知識,做出了實際可利用的攻擊。部分問題早在 2024 年就被識別,但當時被判定「太複雜、人類難以利用」,所以放著沒補。
Wiz 的研究員 Sagi Tzadik 講得最直白:「這個漏洞 PHP 團隊已經知道多年,但因為無法被攻擊者利用,至少不是被人類攻擊者利用,所以一直沒處理。」
人類看不上的洞,AI 一接手就變成當週的危機。同一個洞,十年的風險評估,一夜之間重算。
三、偏見會跟著擬人化一起放大,而且當事人不自覺
第三件事來自愛爾蘭的利默瑞克大學(University of Limerick)。研究團隊請 189 名知識工作者走進虛擬實境(VR)辦公室,跟 AI 助理共事,再依表現用真實金額分配報酬。所有 AI 助理的底層技術和工作表現完全相同。
結果:男性外觀的 AI 助理「Johan」拿到的平均報酬,比女性外觀的「Johanna」高出約 10%,而且還被評為更「有人性」。
真正棘手的是後續訪談。絕大多數受試者堅稱,性別完全不影響他們的給薪判斷。行為和認知之間的這個落差,才是偏見溜進系統的路徑:你以為自己沒餵進去,其實早就在不知不覺中餵了。
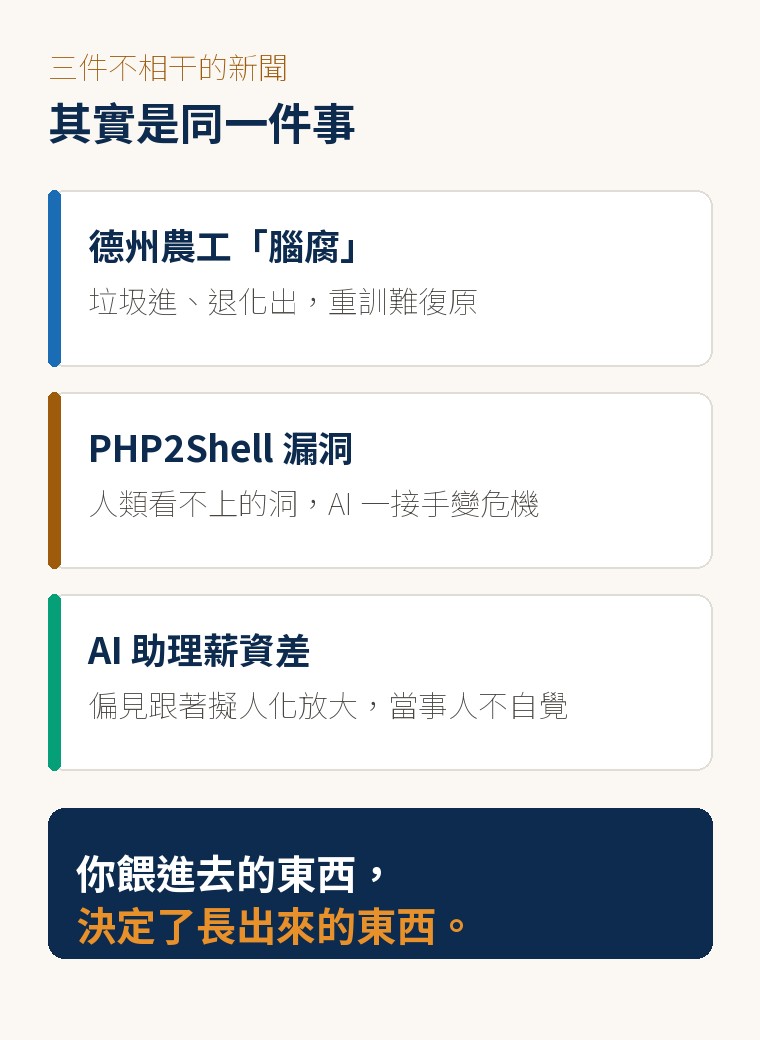
三件事,同一件事:乾淨輸入
把這三件事擺在一起看,它們講的是同一個道理:你餵進去的東西,決定了長出來的東西,而「髒」常常是看不見、不自覺的。
腦腐研究證明的是「垃圾進、退化出、重訓難復原」;PHP 風暴證明的是「人類看不上的洞,會被 AI 放大成危機」;性別薪資差證明的是「偏見跟著擬人化一起放大,而且當事人不自覺」。
對中小企業的翻譯很直接:你現在餵給 AI 的資料、範例、訓練素材,就是你公司未來的判斷力。餵錯料不是重灌就好,是長歪了之後救不回來。
所以我們建議,在導入 AI 之前,先替它的輸入資料設一道關,就問三件事:
- 1誰能餵:哪些人、哪些系統,有權把資料餵進 AI?沒有被授權的,一律進不來。
- 2餵什麼:餵進去的資料有沒有分級?哪些可以進公開模型,哪些必須留在地端,哪些根本不該餵?
- 3餵之前要不要抽檢:上線之前抽一批出來看,比事後發現問題再稽核,便宜太多。
這道關,比任何事後稽核都便宜,因為髒東西進去之後就清不掉了。
我們自己也在守這一關
我們自己的內容產線,其實一直在做這件事。我們堅持「失敗公開、實測數字」,本質上就是在幫內容和決策守住乾淨輸入:不編數字、不憑印象、引用要回一手來源查證。因為我們很清楚,我們產出的每一篇文章、每一個判斷,都會成為下一代內容的訓練素材。自己先餵乾淨,才敢談護城河。
今晚就能做的一件事
下班前,花十分鐘做一件事:打開你正在用的任何一個 AI 工具,問自己三個問題。誰有權把資料餵進去?現在餵進去的料乾不乾淨?上一次抽檢是什麼時候?
如果你答不出來,那你的 AI 員工,現在可能正在你看不到的地方,吃進你看不到的料。
如果你想把「乾淨輸入」這道關,落成一套誰能餵、餵什麼、抽檢頻率的制度,歡迎跟我們聊聊。
資料來源
- •德州農工大學研究團隊(Zhengzhong Tu et al.),《LLMs Can Get "Brain Rot"!》,arXiv:2510.13928,2026-10 發布
- •Texas A&M University,《AI models can get brain rot, too》,stories.tamu.edu,2026-10-21
- •TechNews,《AI 也會「腦腐」?研究警告:吸收過多農場文將導致 AI 推理退化且難以逆轉》,technews.tw,2026-10-25
- •Wired(Lily Hay Newman、Matt Burgess),《The PHP Meltdown Shows How AI Makes Bugs More Exploitable》,wired.com,2026-10-24
- •TechNews,《表現完全相同,研究:男性外觀 AI 助理薪資比女性高約 10%》,technews.tw,2026-10-26